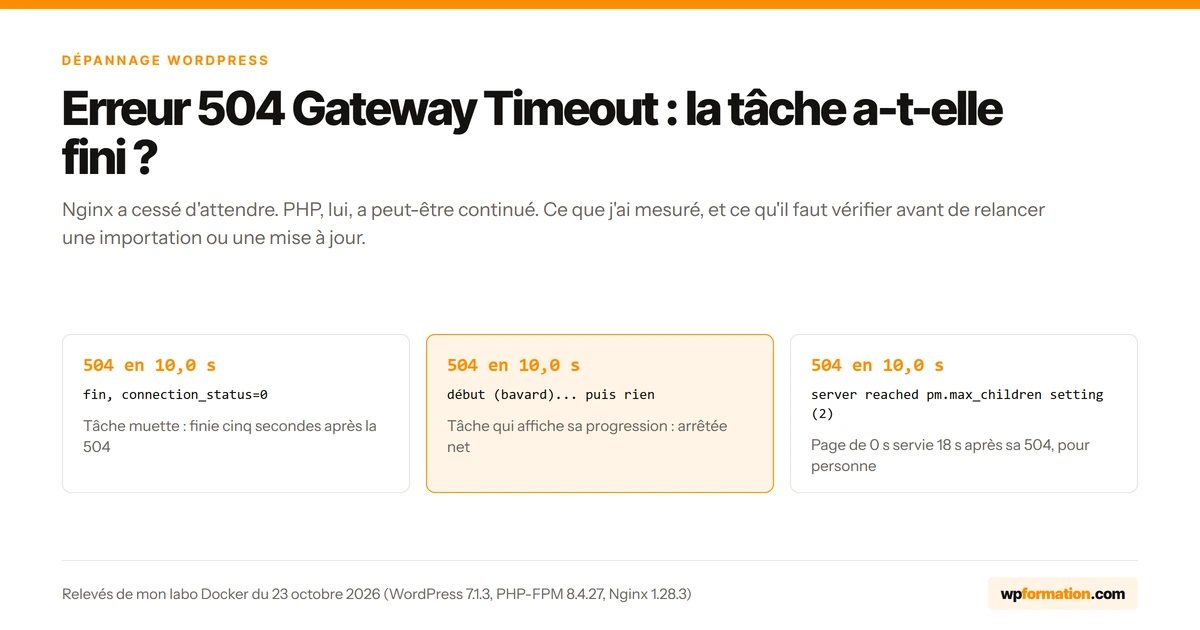
Une erreur 504 Gateway Timeout est écrite par une passerelle (Nginx ou Apache, en général) qui a cessé d’attendre le serveur placé derrière elle, le plus souvent PHP. Elle ne dit pas que le travail a échoué : dans mon labo, une tâche coupée par Nginx a fini 5 secondes après la 504, une autre s’est arrêtée net. Avant de relancer une importation ou une mise à jour, vérifiez si elle a abouti.
Pas le temps ? Faites-le analyser par l'IA
Vous me lisez souvent ? Dites-le à Google
J'ajoute WPFormation à mes sourcesLe 10 octobre au soir, sur un serveur OpenLiteSpeed que j’administre, mes sondes de surveillance ont buté sur un site qui ne répondait plus. Elles abandonnent au bout de 20 secondes : elles n’ont reçu aucun code, ni 504 ni autre chose.
Au même moment, le robot d’un outil SEO attendait un petit fichier texte. Il a patienté cinq minutes, puis reçu une 500. Googlebot aussi est passé ce soir-là, et a buté une fois.
La machine, elle, se reposait : charge de 0,06, 5 460 Mo de mémoire disponible, un seul processus PHP pour ce site, lancé 19 secondes plus tôt et occupé à 0,2 % du processeur. Rien n’était saturé. PHP attendait quelque chose…
Une 504 raconte ce genre d’attente, du point de vue de celui qui s’est lassé le premier. Le code change selon qui abandonne, et la requête abandonnée ne s’arrête pas forcément. J’ai mesuré les deux dans un labo, et je vous raconte plus bas la fin de l’histoire d’OpenLiteSpeed.
Que signifie une erreur 504 Gateway Timeout ?
La norme HTTP (RFC 9110, section 15.6.5) la définit ainsi : un serveur, agissant comme passerelle ou comme proxy, n’a pas reçu à temps la réponse du serveur en amont dont il avait besoin. Sur un site WordPress, la passerelle est Nginx ou Apache devant PHP-FPM, un cache comme Varnish, ou un CDN comme Cloudflare.
La 502, sa voisine, signale une réponse invalide, une connexion coupée en pleine réponse par exemple. La 504 dit seulement qu’un délai a expiré. Elle désigne celui qui a perdu patience, jamais ce qui coinçait derrière.
Une 504 se règle-t-elle toute seule ? Si la lenteur venait d’une pointe de visites passagère, oui : la page suivante arrive à temps. Si elle vient d’une tâche trop longue pour le délai, elle revient à chaque fois que la tâche tourne, à la même minute s’il s’agit d’une tâche planifiée.
Pour le référencement, la documentation de Google sur les codes HTTP traite la 504 comme les autres 5xx : l’exploration ralentit, le contenu reçu est ignoré, et des pages indexées finissent par sortir de l’index si l’erreur s’installe. Quelques 504 isolées passent ; une page qui en renvoie chaque nuit au passage de Googlebot, moins.
Le labo : la 504 tombe, PHP continue
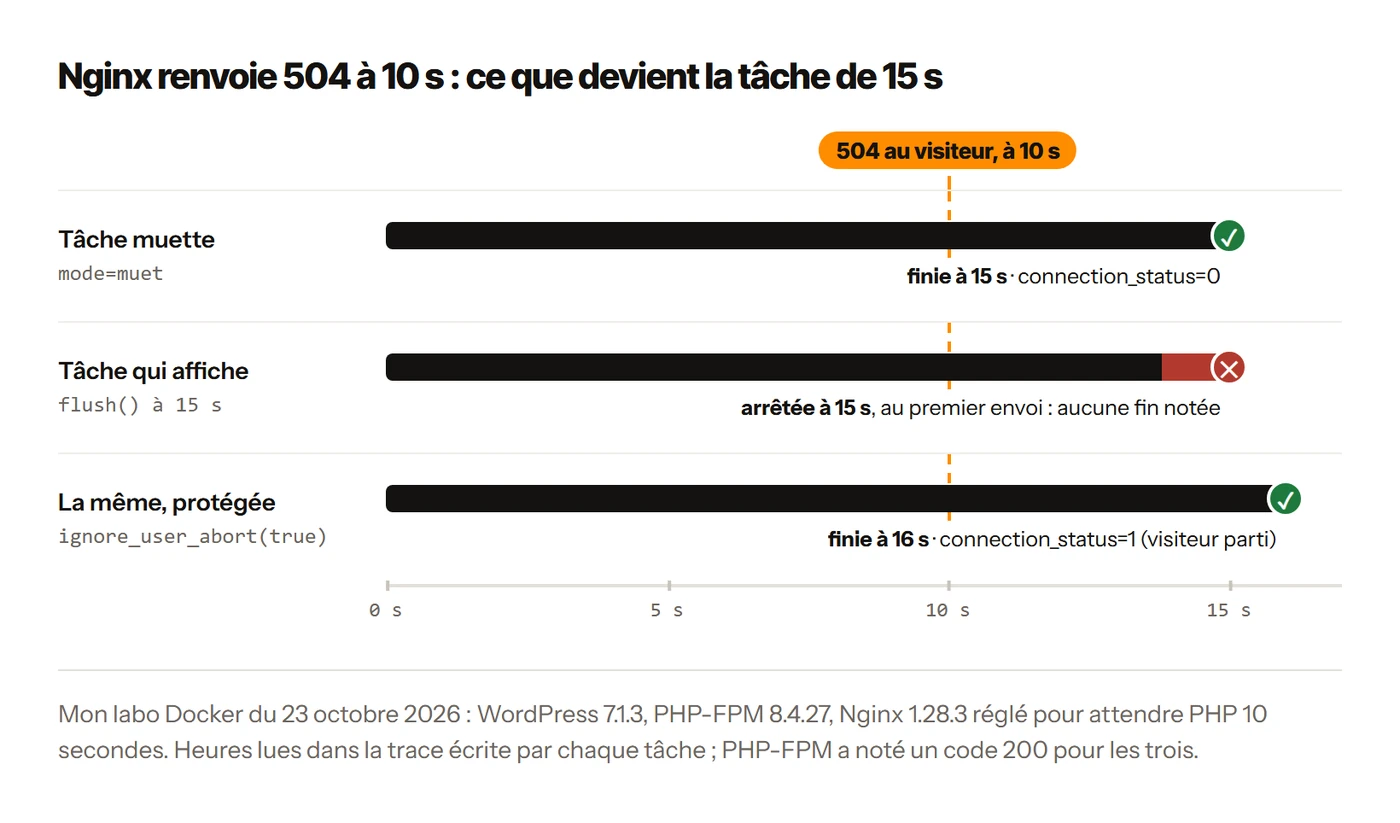
Le 23 octobre, j’ai repris le labo Docker monté sur mon poste pour mes articles sur les erreurs 50x : WordPress 7.1.3 sur PHP-FPM 8.4.27, derrière Nginx 1.28.3, que j’ai réglé pour attendre PHP 10 secondes. J’ai lancé une tâche de 15 secondes, qui note dans un fichier l’heure de son début et celle de sa fin, de trois façons :
| Tâche de 15 secondes | Ce que reçoit le visiteur | Ce qui se passe dans PHP |
|---|---|---|
| Muette jusqu’à la fin | 504 en 10,0 s | Elle finit à 15 s, 5 secondes après la 504 |
| Elle affiche sa progression à 15 s | 504 en 10,0 s | Elle s’arrête au premier affichage : la fin n’est jamais notée |
Même tâche, avec ignore_user_abort(true) | 504 en 10,0 s | Elle finit, en notant que le visiteur est parti |
Dans les trois cas, Nginx a écrit la même ligne dans son journal d’erreurs, à la dixième seconde :
upstream timed out (110: Connection timed out) while reading response header from upstreamCôté PHP, la documentation de PHP l’écrit noir sur blanc : PHP ne remarque le départ du visiteur qu’à la prochaine tentative d’envoi. Une tâche muette ne tente rien, et va au bout. Une tâche qui envoie vraiment sa progression (avec flush(), ou quand le tampon de sortie déborde) se heurte à une connexion fermée, et PHP l’arrête là.
Sauf si le code a demandé à PHP d’ignorer ce départ. C’est ce que fait wp-cron.php, le fichier qui lance les tâches planifiées de WordPress, dès sa ligne 19 : ignore_user_abort( true ). Dans le cœur de WordPress 7.1.3, aucun autre fichier ne le fait, hormis une bibliothèque de lecture des métadonnées audio et vidéo.
Un succès de façade : le journal de PHP-FPM a noté un code 200 pour les trois tâches, y compris celle qui s’est arrêtée au milieu. Ce 200 reprend le code que le script comptait renvoyer, il ne dit rien du travail accompli.
Que faire après une 504 sur une importation ou une mise à jour ?
Ne relancez pas tout de suite. Si la tâche était muette, elle tourne peut-être encore, et la relancer revient à la faire deux fois : deux importations du même fichier, par exemple, ou deux envois d’une même campagne. Si elle écrivait sa progression, elle s’est peut-être arrêtée au milieu, et c’est un état à moitié fait qu’il faut constater avant d’agir.
Comment savoir si elle a fini ? Par son résultat : le nombre de produits ou d’articles importés, la version affichée dans Tableau de bord > Mises à jour, la date de la dernière sauvegarde. Laissez passer quelques minutes, puis comparez. Si le nombre bouge encore d’un rechargement à l’autre, la tâche tourne toujours.
Pour les tâches longues, la ligne de commande évite le problème à la racine. Avec WP-CLI, aucune passerelle n’attend la réponse, et PHP en ligne de commande n’a aucune limite de durée par défaut. Une mise à jour ou une importation lancée ainsi va au bout, ou s’arrête sur une erreur que vous lisez dans le terminal.
Sur une connexion SSH fragile, lancez-la dans screen ou tmux, sinon une coupure de la session arrête la commande.
Et les tâches planifiées ? Celles que lance wp-cron.php ne provoquent même pas de 504 sous PHP-FPM ou LiteSpeed : le fichier rend la réponse tout de suite (fastcgi_finish_request() ou litespeed_finish_request(), lignes 28 à 30) puis travaille en arrière-plan. Ailleurs, la ligne vue plus haut les protège : elles se comportent comme la troisième tâche du tableau, dans la limite des autres délais de PHP. Elles occupent pourtant un processus PHP tout du long. Le plus sûr reste de les confier au cron du serveur, par WP-CLI. Pour la mise en place, je vous invite à lire mon guide sur WP-Cron.
La file d’attente de PHP-FPM
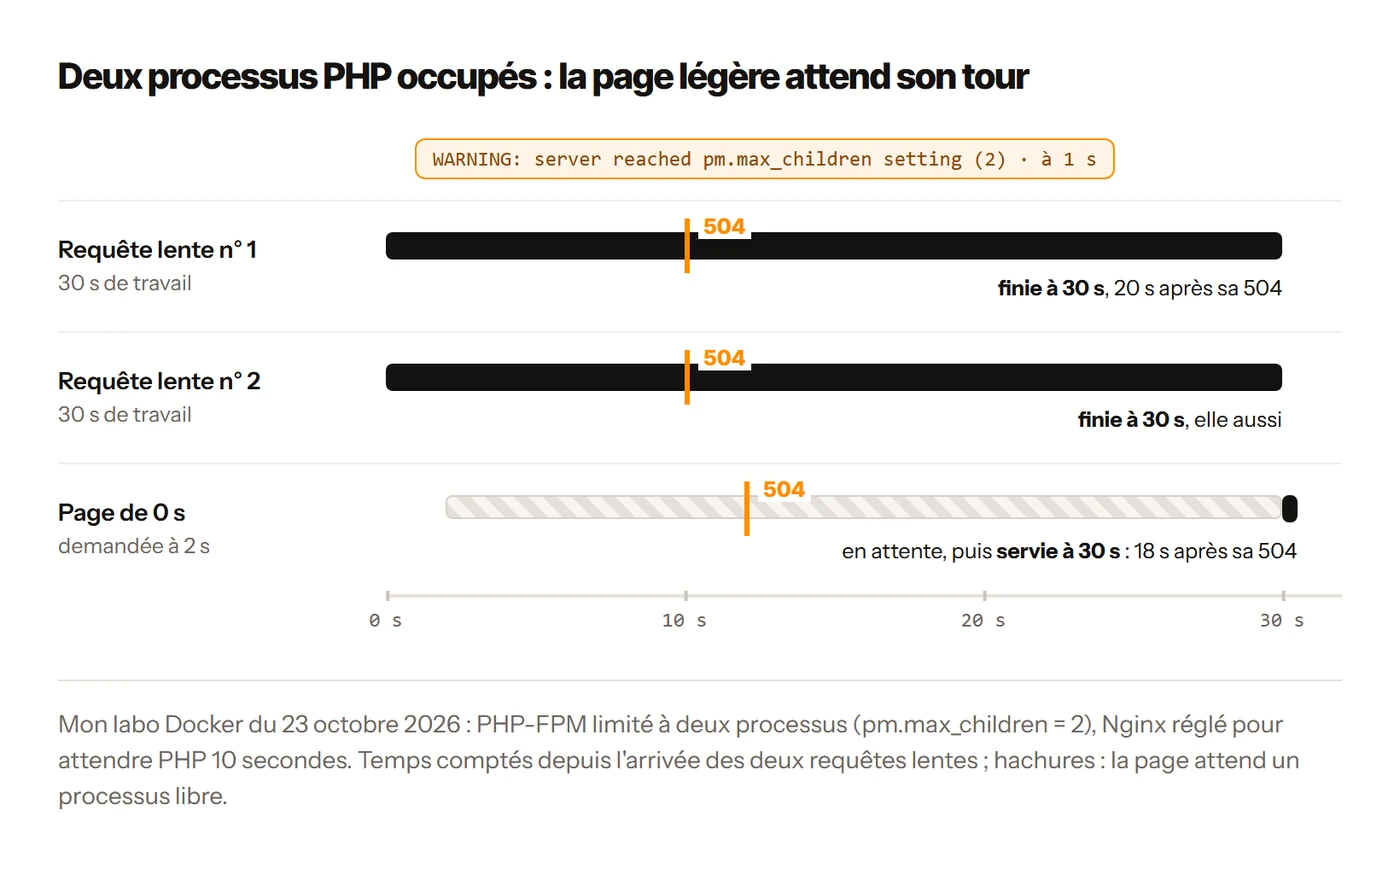
Une page légère peut tomber en 504 simplement parce qu’elle attend son tour. J’ai réduit le labo à deux processus PHP, occupés chacun par une requête de 30 secondes, puis j’ai demandé une page qui répond en zéro seconde. Elle a reçu une 504 au bout de 10 secondes, comme les deux autres. Elle n’avait pourtant rien à calculer : aucun processus n’était libre pour la prendre.
Le journal de PHP-FPM l’avait annoncé, une seconde avant même ma demande :
WARNING: [pool www] server reached pm.max_children setting (2), consider raising itLa suite m’a amusé. Une fois les deux processus libérés, PHP-FPM a pris la page en attente et l’a servie, 18 secondes après que Nginx eut répondu 504. Pour personne…
Sur un vrai site, ces deux requêtes lentes sont une importation, un export, un robot qui enchaîne les recherches internes. La 504 tombe ailleurs, sur la page d’accueil d’un visiteur qui n’y est pour rien. Cherchez "max_children" dans le journal de PHP-FPM avant d’accuser la page qui a échoué. En mode static, rien ne s’écrit : passez par la page d’état de PHP-FPM.
Monter pm.max_children soulage, à condition d’avoir la mémoire : chaque processus PHP occupe sa part, 53 Mo pour celui de mon serveur OpenLiteSpeed le soir du 10 octobre. Pour savoir qui occupe les processus, le fichier slowlog de PHP-FPM note la pile d’appels des requêtes qui dépassent le seuil de request_slowlog_timeout.
Calculez pm.max_children avant de le monter : divisez la mémoire que vous laissez à PHP par celle d’un processus. Avec 53 Mo par processus, 1 Go laissé à PHP donne dix-neuf processus. Au-delà, le serveur manque de mémoire et le noyau tue des processus : la 504 devient une 502.
Une extension qui attend une API lointaine
Une extension qui interroge un service extérieur, une API de paiement, de traduction ou de suivi de colis, passe d’ordinaire par wp_remote_get(). WordPress y fixe un délai de 5 secondes par défaut, réglable par le filtre http_request_timeout.
Dans le labo, j’ai fait appeler par WordPress, avec wp_remote_get(), une API qui met 30 secondes à répondre. Avec le délai par défaut, la page est arrivée en 5,3 secondes, sans la donnée attendue, et avec ce message dans l’erreur reçue par le code : cURL error 28: Operation timed out after 5002 milliseconds. Lente, la page restait servie.
Puis j’ai monté ce délai à 30 secondes, ce que toute extension peut faire pour ses propres appels. La page a attendu l’API, Nginx a abandonné à 10 secondes : 504. L’API n’a d’ailleurs pas répondu dans les 30 secondes, et PHP s’est arrêté en voulant envoyer la page, comme la tâche bavarde du tableau.
Une 504 sur certaines pages seulement, celles qui affichent un widget, un tarif de livraison ou un flux, pointe donc souvent vers un appel extérieur. J’ai listé dans mon article sur les métriques WordPress cachées comment repérer ces appels et leur durée.
Ne montez pas le délai de Nginx pour tout le site
C’est le réflexe de beaucoup de guides : monter les délais de Nginx, parfois jusqu’à 300 secondes, et la 504 disparaît. Elle disparaît surtout de la vue… La requête lente occupe toujours un processus PHP, plus longtemps, et le maillon suivant coupe à sa place.
Voici les délais que l’on croise entre le visiteur et WordPress, avec le code que chacun produit quand il expire :
| Qui attend | Réglage | Par défaut | Ce que reçoit le visiteur |
|---|---|---|---|
| WordPress, pour une API | http_request_timeout | 5 s | la page, sans la donnée (200 en 5,3 s dans le labo) |
| PHP | max_execution_time | 30 s de calcul | 500 |
| PHP-FPM | request_terminate_timeout | 0 (désactivé) | 502 |
| Nginx | fastcgi_read_timeout | 60 s entre deux lectures | 504 |
| Varnish | first_byte_timeout | 60 s | 503 "Backend fetch failed" |
| Cloudflare | Proxy Read Timeout | 125 s | 524 |
Varnish m’a d’ailleurs rappelé qu’un délai dépassé ne donne pas toujours une 504. Réglé pour attendre 10 secondes devant un Nginx patient, il a répondu "503 Backend fetch failed", avec sa page Guru Meditation et un en-tête Retry-After: 5. Nginx, lui, a noté un code 499 : le client, Varnish, avait raccroché.
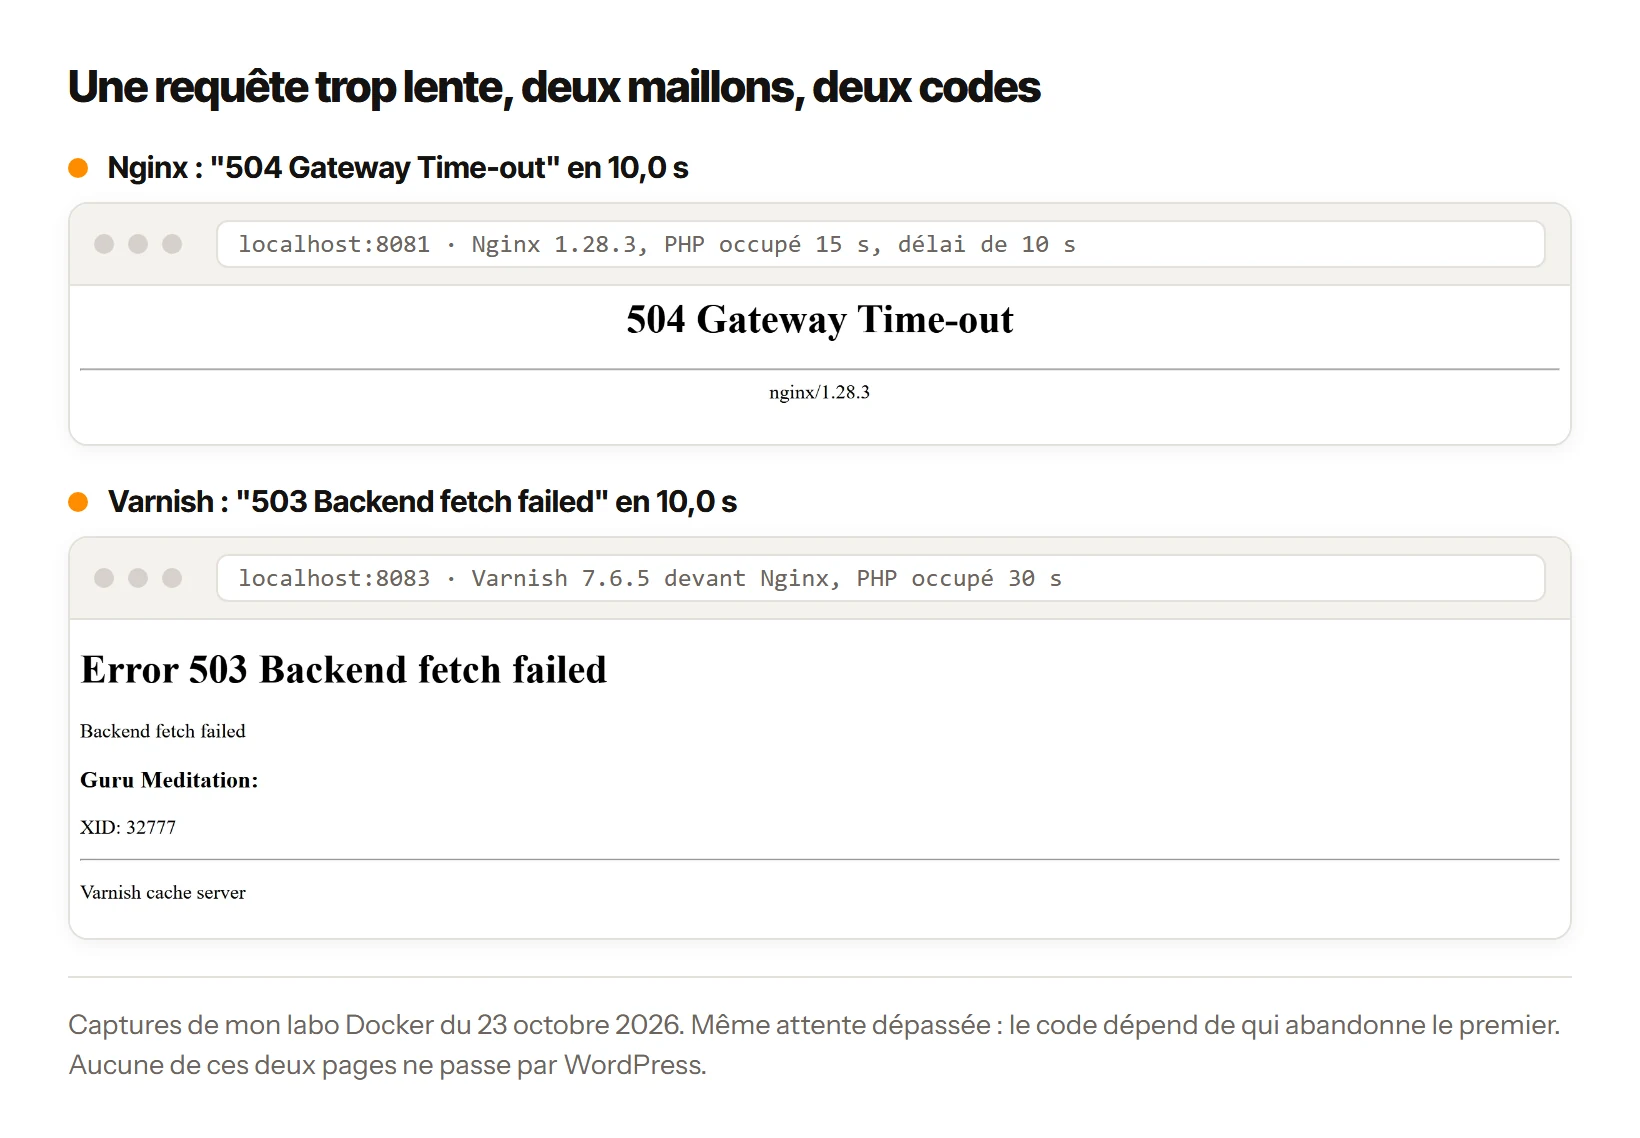
Le délai de Nginx a aussi une subtilité, que la documentation de Nginx précise : il compte le silence entre deux lectures, pas la durée totale. Une page qui envoyait un octet toutes les 4 secondes a tenu 24 secondes derrière un délai de 10, et elle est arrivée en 200.
Monter le délai a un sens pour une adresse précise qui en a besoin, une exportation par exemple. Pour tout le site, il masque la cause. Toutefois, derrière Cloudflare, une page restée muette 125 secondes reçoit une 524 (hors offre Enterprise), quel que soit le réglage de votre serveur.
La 504 et la 524 derrière Cloudflare
Le 23 octobre, à la question "erreur 504 gateway timeout sur mon site wordpress, que faire ?", le Mode IA de Google expliquait qu’un CDN comme Cloudflare "peut renvoyer une erreur 504 si votre serveur d’hébergement ne répond pas assez vite". La documentation de Cloudflare décrit autre chose…
D’après sa page sur l’erreur 524, quand votre serveur a accepté la connexion mais ne répond pas dans le délai de 125 secondes, Cloudflare renvoie une 524. Seule l’offre Enterprise peut porter ce délai jusqu’à 6 000 secondes.
Pour les traitements plus longs, comme un gros export, Cloudflare conseille de les servir par un sous-domaine qui ne passe pas par lui (enregistrement DNS seulement), ou de suivre leur avancement par des requêtes courtes.
Une 504 vue derrière Cloudflare vient donc le plus souvent de chez vous, et Cloudflare le dit. Sa page sur les erreurs 502 et 504 donne le moyen de trancher : une 504 aux couleurs de Cloudflare relaie celle de votre serveur d’origine, une page blanche sans sa marque vient de Cloudflare.
Nota : la même page signale des 504 qui apparaissent dans les journaux ou les statistiques de Cloudflare sans qu’un visiteur ait vu d’erreur, liées aux Early Hints ou au cache des Workers, et juge celles des Early Hints sans conséquence. Un pic de 504 dans un tableau de bord ne prouve donc pas une panne : vérifiez la page elle-même.
Le blocage qui ne disait pas son nom
Retour au serveur OpenLiteSpeed du 10 octobre. Son journal d’erreurs répétait une ligne, 45 fois le 8 octobre, 35 fois le 10 :
No request delivery notification has been received from LSAPI application, possible dead lockAutrement dit, le serveur web attendait que PHP accuse réception de la requête, et l’accusé n’était jamais venu. Un délai plus long n’y aurait rien changé, le robot l’a vérifié pendant cinq minutes. Le journal d’erreurs PHP du site restait vide, et celui qu’OpenLiteSpeed tient pour PHP, stderr.log, n’est même pas lisible par les comptes des sites.
journalctl -k écartait le plantage : aucun processus PHP tué, aucun manque de mémoire. La clé était dans le journal du serveur lui-même. Les 12 derniers épisodes commençaient tous pendant une relance du groupe de processus PHP du site.
Pourquoi tant de relances ? L’environnement de ce groupe portait LSAPI_PGRP_MAX_IDLE=60 : sans requête PHP pendant 60 secondes, il s’arrêtait. Or ce site sert l’essentiel de ses pages depuis LiteSpeed Cache, sans réveiller PHP. Le cache, trop efficace, endormait PHP… 142 à 355 relances par jour, du 7 au 10 octobre.
La documentation de LiteSpeed Web Server, l’édition commerciale, donne "FOREVER" comme valeur par défaut de ce réglage. Celle d’OpenLiteSpeed dit l’inverse : le mode détaché "ne veut pas dire que PHP tournera indéfiniment", et il faut monter Max Idle Time. J’ai d’abord essayé la clé maxIdleTime sur un site de test. Refusé au rechargement : "Not support [maxidletime 3600]".
Le nom accepté, extMaxIdleTime, je l’ai trouvé dans le binaire d’OpenLiteSpeed lui-même. Je l’ai posé à 3600 sur quatre sites, au prix d’un processus parent d’environ 45 Mo par site, qui reste en mémoire. Du 11 au 18 octobre, plus aucune ligne "possible dead lock".
Un seul épisode ensuite, le 19 : cinq lignes dans la même seconde pour une seule adresse cliente, sans relance de PHP autour. Celui-là n’a pas encore livré sa cause.
Des 504 à chaque import ? Je trouve ce que PHP attend.
Découvrir la maintenanceAvant de toucher aux délais
Face à une 504, je pars de ce que je peux mesurer sans rien changer :
- le temps exact avant l’erreur, avec
curl -s -o /dev/null -w "%{http_code} en %{time_total} s\n" https://example.com/page-lente/: une 504 qui tombe toujours à 60,0 secondes pointe vers le délai par défaut de Nginx (ou d’Apache), une 524 à 125 secondes celui de Cloudflare ; - l’étendue : une seule adresse (un appel extérieur, une tâche lourde) ou tout le site (des processus PHP tous occupés) ;
- le journal de PHP-FPM, à la recherche de
pm.max_children, et leslowlogs’il est activé ; - le résultat de la tâche interrompue, avant toute relance.
Sous Windows, tapez curl.exe (dans Windows PowerShell, curl désigne une autre commande) et remplacez /dev/null par NUL.
Si la page renvoie une 500 plutôt qu’une 504, le problème se trouve le plus souvent dans PHP lui-même : une fois WP_DEBUG et WP_DEBUG_LOG activés, le debug.log en donne la ligne. Vous trouverez la marche à suivre dans mon article sur le débogage de WordPress. Les autres pannes ont leur fiche dans mon récapitulatif des erreurs WordPress.
Et après une mise à jour qui s’est terminée sur une 504, je regarde la version affichée par WordPress avant de cliquer à nouveau. Nginx a seulement cessé d’attendre.
Questions fréquentes
Une erreur 504 vient-elle de WordPress ?
En général, non. C’est la passerelle placée devant PHP qui l’écrit quand elle cesse d’attendre, Nginx ou Apache le plus souvent. La cause, elle, se trouve souvent du côté de WordPress : une extension qui attend une API, une importation trop longue, ou des processus PHP tous occupés.
Faut-il relancer une importation tombée en 504 ?
Pas tout de suite. La 504 dit que la passerelle a cessé d’attendre, mais elle ne dit pas que la tâche a échoué : dans mon labo, une tâche muette a fini 5 secondes après l’erreur. Vérifiez d’abord son résultat, puis passez les tâches longues par WP-CLI, sans passerelle qui attende.
Augmenter fastcgi_read_timeout corrige-t-il une 504 ?
Il la fait disparaître de la vue, sans régler la cause. La requête lente occupe toujours un processus PHP, et le maillon suivant coupe à sa place : derrière Cloudflare, c’est une 524 au bout de 125 secondes. Réservez un délai plus long à une adresse qui en a besoin, une exportation par exemple.
Quelle différence entre une 504 de Cloudflare et une 524 ?
Une 504 aux couleurs de Cloudflare relaie celle de votre serveur d’origine ; sur une page blanche, sans sa marque, elle vient de Cloudflare lui-même. Cloudflare répond 524 quand votre serveur a accepté la connexion mais reste muet 125 secondes, hors offre Enterprise.
Sources
Sources lues le 23 octobre 2026 ; labo Docker monté sur mon poste le même jour, journaux conservés. Version du labo : Nginx 1.28.3, branche ancienne, messages identiques dans le code actuel. Citations anglaises traduites par mes soins.
- Norme HTTP : RFC 9110, section 15.6.5 "504 Gateway Timeout"
- Google : traitement des codes HTTP par les robots d’exploration
- PHP : gestion des connexions (ignore_user_abort, connection_status), directive max_execution_time et configuration de PHP-FPM (pm.max_children, request_terminate_timeout, slowlog)
- WordPress : filtre http_request_timeout
- Nginx : directive fastcgi_read_timeout
- Cloudflare : erreur 524 et Proxy Read Timeout et erreurs 502 et 504, origine ou Cloudflare
- LiteSpeed : options de LSPHP (LSAPI_PGRP_MAX_IDLE)
La chaîne WordPress + IA de ce site, en 12 étapes. Le guide vous donne la méthode pour la refaire à la main.
De la veille à la mesure, avec Claude Code, sur un WordPress classique.
- La carte des 12 étapes du workflow
- Une checklist et un prompt par étape
- 3 skills de départ à copier
- Les garde-fous nés de vrais incidents
Double opt-in : un email de confirmation à valider pour recevoir le guide. Newsletter max 2/mois. WPFormation utilise les données saisies, via Brevo, pour votre inscription et les emails annoncés, avec votre consentement. Données jamais revendues. Désabonnement en 1 clic. Vos droits et la conservation de vos données
Voir le détail du guide et de la version complète