Le fichier robots.txt indique aux moteurs de recherche quelles parties de votre site WordPress explorer ou ignorer. Ce guide explique sa syntaxe, sa configuration et les erreurs à éviter.
Pas le temps ? Faites-le analyser par l'IA
Vous me lisez souvent ? Dites-le à Google
J'ajoute WPFormation à mes sourcesLe fichier "Robots.txt" utilise le "protocole d'exclusion des robots (bots)". Il est situé à la racine de votre site WordPress et c’est le premier fichier analysé par les robots des moteurs de recherches (tels que Google, Bing, Yahoo…).
Il permet de donner des instructions sur l’exploration de vos pages et autres éléments de votre site web. Si WordPress propose un fichier "robots.txt" virtuel fourni dès son installation, le modifier vous permet de mieux gérer le contenu exploré par les moteurs de recherche.
Nous allons voir dans cet article tutoriel, la définition, les usages et la mise en place d’un fichier Robots.txt pour WordPress.

Pourquoi paramétrer son fichier Robots.txt ?
Lorsque vous créez votre site web, il se peut que vous n'ayez pas envie de référencer certaines de vos pages sur les moteurs de recherche.
Par exemple, votre site propose le téléchargement de documents PDF, accessibles après le remplissage d'un formulaire. Vous souhaitez que les pages qui présentent ces PDF soient indexées mais pas le document PDF en lui-même. Ce n’est pas le rôle du fichier robots.txt : il sert à limiter l’exploration de certaines adresses par les robots, pas à les retirer de Google. Pour qu’une page ou un PDF n’apparaisse pas dans les résultats, utilisez une instruction noindex (balise meta robots, ou en-tête X-Robots-Tag pour un PDF) et laissez l’adresse explorable.
En tout, vous pouvez définir quatre instructions :
- Demander aux robots d'ignorer toutes vos pages (dans ce cas, vos pages ne seront plus explorées, mais leurs adresses peuvent encore apparaître dans les résultats des moteurs de recherche)
- Interdire à certains robots d’explorer les pages de votre site (uniquement Google par exemple)
- Interdire l'exploration de certaines pages, dossiers ou fichiers à tous les robots
- Interdire l'exploration de certaines pages, dossiers ou fichiers à certains robots
Attention, le fichier robots.txt n'est pas nécessairement pris en compte par les "bots". Il ne s'agit que d'un indicateur et l'indexation de vos pages dépend également d'autres éléments (comme par exemple, les liens qui pointent vers votre site).
Il se peut que certaines d'entre elles s'affichent dans les résultats des moteurs de recherche car des sites y font référence alors que vous aviez donné l'instruction de les ignorer. Dans ce cas, si les bots ont respecté vos instructions, votre page s'affichera dans les résultats de recherche mais sans Méta Description. Google indiquera simplement :

Comment paramétrer son fichier Robots.txt ?
Sur WordPress, un fichier robots.txt virtuel est créé de base. Pour accéder à la version de votre robots.txt, saisissez dans votre barre d'adresse : monnomdedomaine.fr/robots.txt. Le fichier virtuel installé par WordPress établit la configuration suivante :

Nota : Tout le monde peut accéder à votre fichier "robots.txt" grâce à l'url votrenomdedomaine.fr/robots.txt. N'utilisez donc jamais le fichier "robots.txt" pour cacher du contenu sur votre site internet car les utilisateurs et robots malveillants connaîtront exactement les URLs et/ou dossiers que vous souhaitez ne pas indexer.
Notez également que si vous avez déjà créé un fichier "sitemap.xml", celui-ci sera automatiquement ajouté à votre fichier robots.txt.
Comme il s'agit d'un fichier virtuel, vous ne trouverez pas de fichier "robots.txt" sur votre serveur. Pour pouvoir paramétrer celui-ci, il vous faut ajouter une extension ou le créer vous-même et l'uploader sur votre serveur.
Pour créer manuellement un fichier robots.txt :
- Utilisez votre éditeur de texte préféré et créez un fichier texte
- Enregistrez le fichier vide avec le nom robots.txt
- Téléchargez ce fichier via FTP à la racine de votre WordPress
A noter également que WordPress propose de nombreuses extensions gratuites :
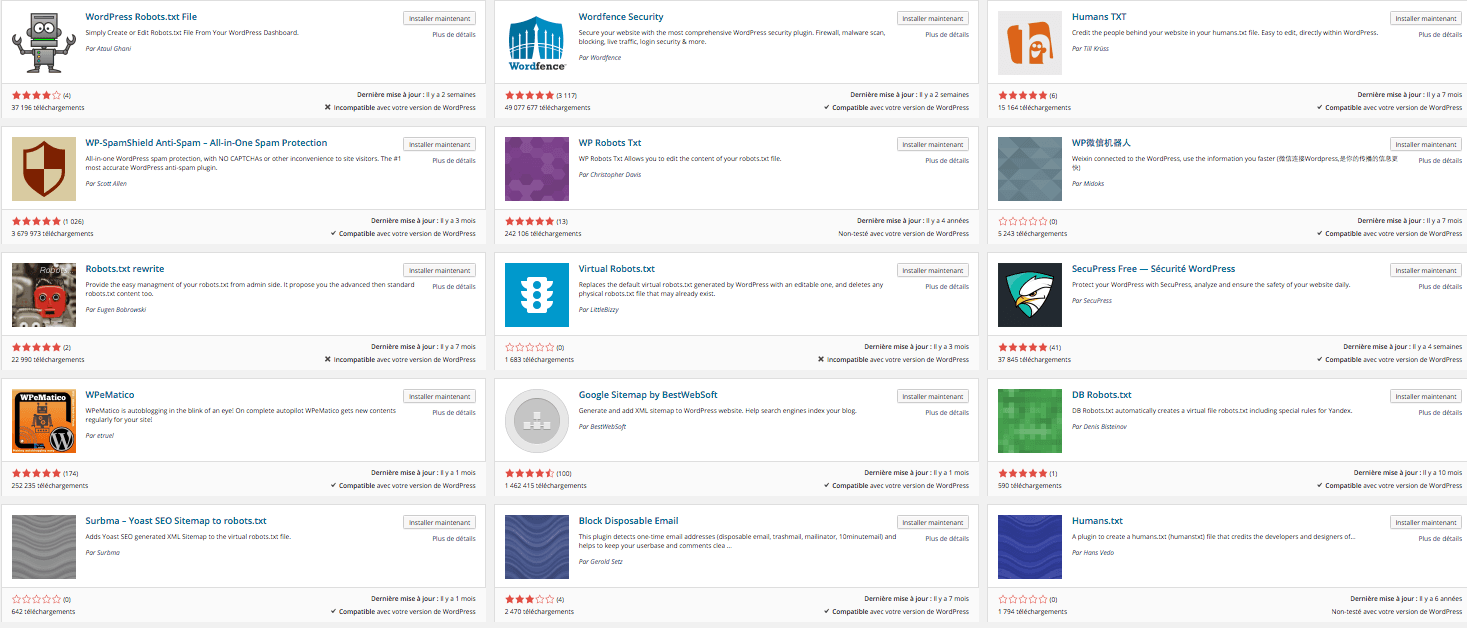
Prenons l'exemple de l'extension Virtual Robots.txt :

Lorsque vous installez et activez l'extension Virtual Robots.txt, elle s'ajoute dans votre barre de menu à gauche de votre Dashboard, dans l'onglet "Réglages".

Ici, vous pouvez modifier votre robots.txt comme bon vous semble. Par défaut, une configuration est déjà en place. Nous verrons dans la dernière partie comment définir celle qui répond le mieux à vos besoins.

Notez que là encore, les extensions ne crée pas de fichier "robots.txt" sur votre serveur. Il s'agit d'un fichier virtuel. Reprenons l'exemple de Virtual Robots.txt. Si j'installe l'extension sur mon site et que j'accède à l'adresse www.monnomdedomaine.fr/robots.txt, le navigateur m'informe qu'il s'agit d'un fichier virtuel géré par le plugin Virtual Robots.

Si vous utilisez le plugin Yoast SEO :
Si vous êtes un adepte de l’excellent plugin Yoast SEO, sachez que vous pourrez aussi éditer et modifier le Robots.txt via son interface. Pour cela rendez-vous dans SEO >> Outils et cliquez sur Éditeur de fichiers.
Nota: Ce menu n'apparaîtra pas, si vous avez désactivé l’édition de fichiers dans WordPress.

Abordons maintenant les bonnes pratiques pour mettre en place votre fichier "robots.txt" et la signification des différentes instructions ci-dessus.
Mettre en place un Robots.txt pour WordPress
Etape 1 : comprendre son site WordPress
Avant de se lancer dans la rédaction de votre fichier "robots.txt", il est important de bien connaître la structure de votre site web. Cela permet de les reporter plus facilement dans le fichier "robots.txt".
Lorsque vous utilisez WordPress et que vous accédez au serveur de votre site web, vous identifiez des fichiers et les répertoires "wp-admin", "wp-content" et "wp-include".

- Le dossier "wp-admin" : il comporte tous les éléments de back-office, d'administration de votre site web.
- Le dossier "wp-content" : il contient vos thèmes, plugins, les images que vous hébergez sur votre site, les fichiers de cache…
- Le dossier "wp-include" : il s'agit de l'ensemble des fichiers de WordPress.
Il y a peu d'intérêt à indexer les dossiers comportant les éléments d'administration du site web et encore moins les éléments constitutifs de WordPress. Le dossier "wp-content" est donc le seul qui comporte les éléments qui nous intéressent (pages, images, articles…). Nous verrons plus bas comment définir ces règles.
Etape 2 : nommer correctement son fichier
Il est important d'insister sur le nommage du fichier. Si celui-ci ne se nomme pas "robots.txt" avec un "s" et tout en minuscules, les robots le considèrent comme inexistant. Ce fichier est un fichier au format texte, qu'il est possible de paramétrer via un outil texte traditionnel (le fichier doit être en .txt) et qui doit toujours être placé à la racine de votre site web.
Pour rappel, il sera toujours accessible à l'adresse : monnomdedomaine.fr/robots.txt.
Etape 3 : comprendre les paramètres de base d'un fichier Robots.txt
Voici à quoi ressemble un fichier "robots.txt" de base :

La première instruction "User-agent" définit le robot. Si vous indiquez "*", cela signifie que tous les robots peuvent accéder à votre site. En revanche si vous indiquez :

Cela signifie que les instructions qui suivent ne concernent que le robot de Google. La seconde instruction "Disallow" indique les contenus que vous ne souhaitez pas faire explorer ; laissée vide, comme dans ces deux exemples, elle n’interdit rien. Par défaut, tous les contenus peuvent être explorés par les robots.
Lorsque vous souhaitez interdire l’exploration de vos pages à tous les moteurs de recherche, il faudra faire suivre "Disallow" d'un "/". Exemple ci-dessous :

Ici, j'interdis à tous les moteurs de recherches (User-agent:*) d’explorer mon site (dans son intégralité grâce au "/"). Ceci est utile lorsque votre site web est encore en création. Notez que WordPress propose aussi un réglage pour les sites en création dans votre Dashboard. Rendez-vous dans les réglages, puis dans le sous-onglet "lecture".

Si vous cochez la case "Demander aux moteurs de recherche de ne pas indexer ce site", WordPress ajoute une balise meta robots noindex à vos pages (le robots.txt virtuel n’est plus modifié depuis WordPress 5.3). Pensez à la décocher à la mise en ligne.
Voyons maintenant comment interdire l'accès à certaines pages ou certains dossiers de votre site web.
Etape 4 : restreindre l'indexation de mes pages ou de mes dossiers
Reprenons la structure classique d'un site WordPress :
Ne bloquez ni /wp-includes/ ni /wp-content/ : Google a besoin des fichiers CSS et JavaScript qu’ils contiennent (thème, extensions, scripts de WordPress) pour afficher vos pages. WordPress n’interdit par défaut que le dossier "wp-admin", qui contient les éléments de back-office, avec une exception pour le fichier admin-ajax.php. Pour la plupart des sites, cette configuration par défaut suffit, complétée de l’adresse de votre sitemap (à adapter) :
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://monsite.com/sitemap_index.xml
Enfin, si vous souhaitez empêcher l’exploration d’une page en particulier (exemple ici avec mapageperso.html), vous pouvez ajouter l’adresse à laquelle elle est accessible :
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /mapageperso.html
Encore une fois nous insistons sur le fait que n'importe qui peut avoir accès à votre robots.txt. Il ne conviendrait donc pas d'ajouter l'url d'une page confidentielle.
Etape 5 : Définir une configuration optimisée pour WordPress
Il existe beaucoup de sites internet qui proposent des configurations optimisées pour WordPress. Cependant, comme chaque site internet est unique, leur fichier robots.txt doit l'être également. Il doit être travaillé en fonction de l'architecture du site.
Tout dépendra de la façon dont votre WordPress est configuré : avec catégories pour mise en place de Silos, utilisation des étiquettes ou non, utilisation des flux RSS, utilisation d’un site ecommerce, etc… De fait, voici à titre d’exemple la configuration que nous avions mise en place pour WPFormation, à adapter à votre site (un fichier robots.txt placé sur votre serveur remplace entièrement celui que génère WordPress) :
User-agent: *
Allow: /wp-admin/admin-ajax.php
# URLs que je ne veux pas indexer : Login Trackbacks Commentaires
Disallow: /wp-login.php
Disallow: /*/trackback
Disallow: /*/comments
Disallow: /cgi-bin
Disallow: /*.php$
Disallow: /*.inc$
Disallow: /*.gz
Disallow: /*.cgi
# URLs autorisées CSS JS Analytics pour les Bots
Allow: /*css?*
Allow: /*js?*
Allow: /*?utm*
Allow: /css/?
# Autoriser Google Image
User-agent: Googlebot-Image
Allow: /*
# Autoriser Google AdSense
User-agent: Mediapartners-Google*
Allow: /*

Sitemap: https://monsite.com/sitemap_index.xml
Etape 6 : Tester votre Robots.txt
Pour tester votre fichier robots.txt, vous devez vous rendre sur la Search Console de Google accessible à cette adresse : https://search.google.com/search-console. Si ce n'est pas déjà fait, vous devez "ajouter une propriété" pour ajouter votre WordPress à la Search Console.

Saisissez l'adresse de votre site internet pour créer cette nouvelle propriété :

La prochaine étape consiste à confirmer que vous êtes bien le propriétaire de ce site web. Pour ce faire, Google vous propose d'uploader un fichier HTML sur votre site web. Voyons comment procéder.
Téléchargez le fichier de validation HTML :

Connectez-vous sur votre serveur FTP via le client FTP que vous utilisez et uploadez le fichier que vous venez de télécharger à la racine de votre site web. Une fois cette étape réalisée, retournez sur la Search Console de Google, confirmez que vous n'êtes pas un robot et validez l'opération.

Vérifions maintenant le fonctionnement de votre fichier "robots.txt". Dans la Search Console, ouvrez Paramètres > Rapport robots.txt pour voir le fichier lu par Google et ses erreurs ; pour une adresse précise, utilisez l’outil d’inspection d’URL, qui indique si elle est bloquée par le robots.txt.
Bonus : Le fichier Humans.txt
Il n’y a pas que les robots dans la vie ! Il y a aussi les humains ;)
Qu’est-ce que c’est ?
C’est une initiative dont le but est de connaître les personnes qui se cachent derrière un site web. C’est un fichier TXT qui contient des informations au sujet des différentes personnes qui ont contribué à la construction du site.
Pourquoi un fichier TXT ?
Parce que c’est simple et rapide à faire. Parce que ça n’a pas d’impact sur le code. Assez souvent, les propriétaires du site ne souhaitent pas que les auteurs y ajoutent leur signature ; soi-disant parce que ça alourdit les pages et rend le site moins rapide.
On le met où ?
A la racine du site. Just à côté du fichier robots.txt. Si c’est possible, vous pouvez aussi ajouter un tag author dans le <head> des pages du site: <link type="text/plain" rel="author" href="http://domain/humans.txt" />
Et je dois le faire parce que ?
Ce n’est pas obligatoire. L’unique but de cette initiative est de connaître les auteurs des sites internet que l’on visite.
Qui je mentionne ?
Qui vous voulez, à condition qu’il/elle soit d’accord. Par exemple, vous pouvez inclure le développeur, le designer, le rédacteur, le SEO, SEM, SMO … La liste peut être longue, puisqu’elle peut inclure tous les acteurs de la conception d’un site web.
Plus d’information sur le fichier Humans.txt.
Conclusion
Si le fichier "robots.txt" n'est pas obligatoire sur votre site WordPress, il vous permet de gérer le contenu qui peut être exploré par les robots des moteurs de recherche. Pour savoir si vous en avez besoin, identifiez si vous souhaitez ne pas faire explorer certaines parties de votre site.
Pour connaître les pages de votre site web visibles par Google, vous pouvez taper sur la barre de recherche "site:monsite.fr". Il affichera alors les pages indexées, mais pas forcément toutes (Google le précise lui-même).
Exemple ci-dessous avec les pages indexées à partir du site de WPFormation. Le "Environ 501 résultats (0,26 secondes)" vous donnera un ordre de grandeur de ce qui est indexé. Si le chiffre vous parait anormalement élevé ou bas, vérifiez vos réglages noindex et le rapport sur l’indexation des pages de la Search Console.

La tendance actuelle est aujourd’hui de bloquer le moins possible les robots des moteurs. Certains sites (tels que Yoast par exemple) ne limitent quasiment en rien les bots des moteurs. Ils partent du principe que les moteurs de recherche savent faire le distinguo entre les différents contenus.
Vous pouvez aussi :
- Utiliser un générateur de fichier robots.txt sur http://tools.seobook.com/
- Lire les recommandations de Google sur https://support.google.com/webmasters/
Maintenant, c'est à vous de jouer ! A vos Robots.txt ;)
Ces 7 templates, je les donne en formation payante. Ici, ils sont gratuits.
Sécurité, SEO, performance, contenu, maintenance - les outils que j'utilise en formation et en audit, avec les prompts IA pour aller 10x plus vite.
- 01Workflow contenu anti-IA
- 02Framework SEO Title/Meta/H1
- 03Audit Express 30 points
- 04Blindage sécurité 10 étapes
- 05Performance web sans plugin
- 06Calendrier maintenance IA
- 07Plan d'action 90 jours
Double opt-in : confirme ton email, puis 1 email / 2 jours pendant 14 jours. Données jamais revendues ni échangées. Désabonnement en 1 clic.