Les robots IA qui visitent un WordPress entraînent des modèles (GPTBot, ClaudeBot), alimentent une recherche (OAI-SearchBot, PerplexityBot) ou agissent pour un utilisateur (ChatGPT-User), ces derniers pouvant ignorer robots.txt. Bloquer GPTBot ne retire pas un site de la recherche de ChatGPT, et Google-Extended n’agit pas sur les aperçus IA. Couper les fonctions IA de WordPress 7 relève d’autre chose : la constante WP_AI_SUPPORT.
Pas le temps ? Faites-le analyser par l'IA
Vous me lisez souvent ? Dites-le à Google
J'ajoute WPFormation à mes sources27 %. C’est la part de tout le trafic d’une boutique WooCommerce cliente qu’aspirait un seul robot le 27 juin 2026 : meta-externalagent, que Meta décrit comme parcourant le Web "pour des usages comme l’entraînement de modèles d’IA de fondation ou l’amélioration de produits". Il martelait le panier, ses fragments et l’API du bandeau de cookies. Des adresses qu’aucun cache ne sert…
La base de données, sur un hébergement mutualisé limité à 35 connexions simultanées, a lâché : "Error establishing a database connection" par intermittence, et des temps de réponse de 5 à 13 secondes. Et pourtant, sur wpformation.com, je laisse entrer les robots d’IA (tous, ou presque, j’y reviens).
Les deux tiennent ensemble. Tout dépend de ce que le robot vient chercher et de ce que votre serveur encaisse. Je parle ici des bots IA qui lisent votre site (on dit aussi robots ou crawlers IA), pas des chatbots qu’on installe dessus.
Et comme WordPress 7 embarque désormais un client IA que vos extensions peuvent brancher sur un fournisseur, une partie à part vous montre comment couper ces fonctions.
Entraînement, recherche, agent : quel robot fait quoi ?
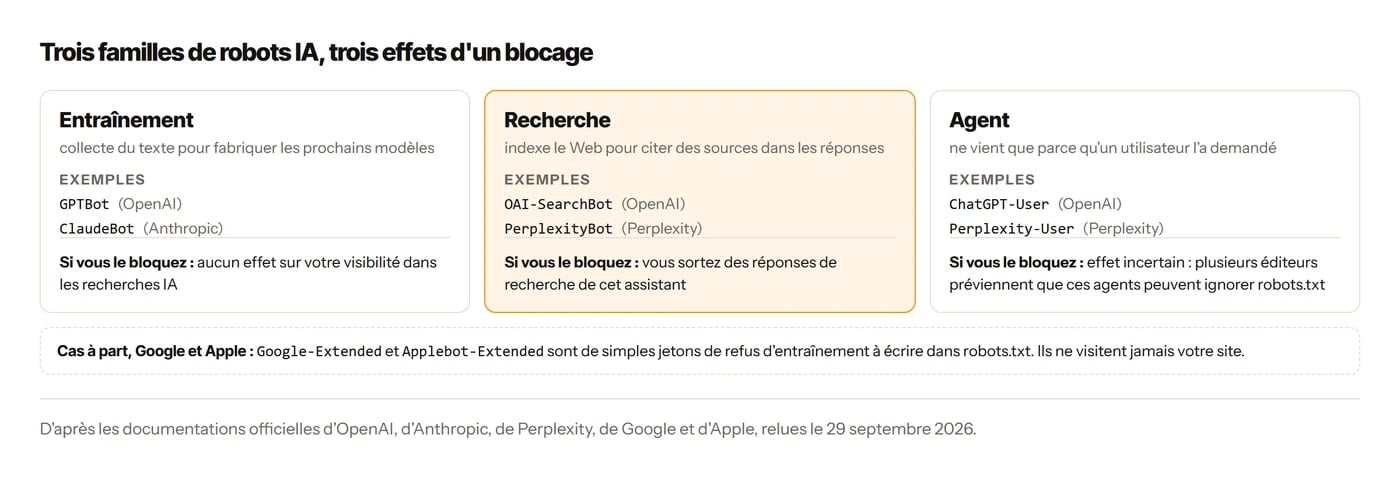
Un robot d’IA est un programme qui télécharge vos pages pour le compte d’une entreprise d’intelligence artificielle. Les éditeurs les rangent en familles : les robots d’entraînement, qui collectent du texte pour fabriquer les prochains modèles ; les robots de recherche, qui indexent le Web pour citer des sources ; les agents, qui ne viennent que parce qu’un utilisateur l’a demandé.
La nuance n’a rien de théorique. Bloquer un robot d’entraînement ne touche pas à votre visibilité dans une recherche IA ; bloquer un robot de recherche vous en fait sortir. Et un agent déclenché par une personne peut, de l’aveu même de plusieurs éditeurs, ne pas lire votre robots.txt.
OpenAI, Anthropic, Mistral et Amazon séparent ces rôles en robots distincts. Google et Apple font autrement : leurs robots habituels explorent le Web, et ils vous donnent un simple jeton à écrire dans robots.txt (Google-Extended, Applebot-Extended) pour refuser l’entraînement. Ce jeton ne visite jamais votre site.
Dans son bilan 2025, Cloudflare mesure que l’exploration déclenchée par les utilisateurs a été multipliée par plus de 15 en un an, même si l’entraînement reste largement majoritaire (jusqu’à 7 à 8 fois l’exploration pour la recherche, au plus fort).
Le tableau des robots IA à connaître en septembre 2026
Voici ce que chaque éditeur écrit dans sa documentation. Les versions changent (OpenAI en est à GPTBot/1.4) : filtrez sur le nom du robot, jamais sur sa version.
| Robot (éditeur) | Rôle | robots.txt, selon l’éditeur | IP publiées | Si vous le bloquez |
|---|---|---|---|---|
| GPTBot (OpenAI) | Entraînement | Un Disallow vaut refus d’entraînement | Oui | Recherche de ChatGPT intacte |
| OAI-SearchBot (OpenAI) | Recherche de ChatGPT | Pris en compte en 24 heures environ | Oui | Absent des réponses de recherche |
| ChatGPT-User (OpenAI) | Agent | "Peut ne pas s’appliquer" | Oui | Sans effet sur la recherche |
| ClaudeBot (Anthropic) | Entraînement | Respecté, Crawl-delay accepté | Oui | Futurs contenus exclus |
| Claude-SearchBot (Anthropic) | Recherche | Respecté | Oui | Moins visible dans Claude |
| Claude-User (Anthropic) | Agent | Respecté | Oui | Pages non lues à la demande |
| Google-Extended (Google) | Jeton : entraînement et ancrage de Gemini | Jeton, aucune visite | Sans objet | Aucun effet sur la recherche Google |
| Google-Agent (Google) | Agent | "Ignorent généralement" les règles | Oui | Aucun jeton documenté : pare-feu |
| PerplexityBot (Perplexity) | Recherche, pas d’entraînement | Autorisation recommandée | Oui | Moins visible dans Perplexity |
| Perplexity-User (Perplexity) | Agent | "Ignore généralement" | Oui | Règle souvent ignorée |
| Applebot (Apple) | Recherche d’Apple, entraînement possible | Respecté, sans Crawl-delay | Oui | Moins visible dans Siri et Spotlight |
| Applebot-Extended (Apple) | Jeton : entraînement | Aucune visite | Sans objet | Hors entraînement |
| meta-externalagent (Meta) | Entraînement, produits | Disallow documenté, pris en compte sous 24 heures | Non indiqué | Aperçus Facebook intacts |
| meta-webindexer (Meta) | Recherche de Meta AI | Disallow documenté, pris en compte sous 24 heures | Non indiqué | Moins visible dans Meta AI |
| meta-externalfetcher (Meta) | Agent | "Peut contourner" | Non indiqué | Règle pas toujours suivie |
| facebookexternalhit (Meta) | Aperçus des liens partagés | Contournable pour la sécurité | Non indiqué | À laisser passer |
| Amazonbot (Amazon) | Entraînement possible | Respecté, cache de 30 jours | Oui | Prise en compte sous 30 jours |
| Amzn-SearchBot (Amazon) | Recherche | Respecté | Oui | Moins visible chez Amazon |
| Amzn-User (Amazon) | Agent (Alexa) | "Peut ne pas suivre" | Oui | Règle pas toujours suivie |
| MistralAI-Training (Mistral) | Entraînement | Interdiction prévue | Non indiqué | Hors entraînement |
| MistralAI-Index (Mistral) | Recherche | Non précisé | Oui | Moins visible chez Mistral |
| MistralAI-User (Mistral) | Agent (Vibe) | Le jeton encadre ces visites | Oui | Pages non lues à la demande |
| CCBot (Common Crawl) | Archive souvent réutilisée pour l’entraînement | Disallow documenté | Oui | Hors des prochaines collectes |
| Bytespider (ByteDance) | Non documenté | Inconnu | Inconnu | Invérifiable |
Ces agents qui peuvent ignorer votre robots.txt
OpenAI écrit à propos de ChatGPT-User que, ses actions étant initiées par un utilisateur, "les règles de robots.txt peuvent ne pas s’appliquer". Perplexity, Google (dont Google-Agent) et Amazon disent la même chose de leurs agents, et Meta de meta-externalfetcher, alors que ses deux autres robots d’IA obéissent à un Disallow.
Anthropic affirme au contraire que ses trois robots respectent robots.txt. Et Cloudflare a observé en 2025 que ChatGPT-User lisait bien le fichier et s’arrêtait quand l’accès lui était interdit. Pour les autres, seul un pare-feu tranche.
Bytespider, le robot sans mode d’emploi
Aucune documentation officielle de ByteDance sur Bytespider n’était accessible le 29 septembre 2026. Selon Cloudflare, ses requêtes ont chuté de 85 % entre mai 2024 et mai 2025. Et sans liste officielle d’adresses, impossible de distinguer le vrai Bytespider d’un imposteur.
Bloquer GPTBot retire-t-il votre site de ChatGPT ?
Non. Chez OpenAI, les réglages sont indépendants : GPTBot pour l’entraînement de ses modèles, OAI-SearchBot pour la recherche de ChatGPT. Vous pouvez refuser le premier et accueillir le second, et OpenAI précise qu’il faut environ 24 heures pour que sa recherche tienne compte d’une modification de robots.txt.
Voici ce qui refuse l’entraînement chez OpenAI sans toucher à la recherche :
User-agent: GPTBot
Disallow: /
La documentation est limpide : un webmaster "peut autoriser OAI-SearchBot pour apparaître dans les résultats de recherche tout en interdisant GPTBot" (ma traduction). Elle ajoute un détail que peu de gens lisent : si les deux robots sont autorisés, OpenAI peut se servir d’un seul passage pour les deux usages.
Et si c’est OAI-SearchBot que vous bloquez ? Vos pages ne s’affichent plus dans les réponses de recherche de ChatGPT, mais elles "peuvent encore apparaître comme liens de navigation", écrit OpenAI.
La version précédente de ce guide affirmait qu’un blocage de GPTBot vous faisait disparaître de ChatGPT "en quelques jours". C’était faux, je le corrige. Anthropic, Mistral et Amazon séparent de la même façon entraînement et recherche.
Perplexity, lui, déclare que PerplexityBot "n’est pas utilisé pour explorer du contenu destiné aux modèles d’IA de fondation" : le bloquer, c’est quitter sa recherche sans rien protéger.
Google-Extended et aperçus IA : le vrai réglage date du 31 août 2026
Google-Extended ne sert pas à sortir des aperçus IA. C’est un jeton que Google lit dans robots.txt pour savoir si votre contenu peut entraîner les futurs modèles Gemini et servir d’ancrage (des extraits fournis au modèle au moment de répondre) dans les applications Gemini et Vertex AI. Google l’écrit noir sur blanc : il "n’a aucune incidence sur l’inclusion d’un site dans la recherche Google".
Mon ancienne version disait l’inverse, je rectifie. Et la question se pose chez nous depuis le 22 juillet 2026, date du lancement des aperçus IA et du mode IA en France (les conséquences sont dans mon guide pour adapter WordPress aux aperçus IA).
Le seul interrupteur officiel s’appelle "Search generative AI", dans les paramètres de la Search Console, déployé pour tous les sites au 31 août 2026. Il couvre les aperçus IA, le mode IA et les fonctions génératives de Discover. En choisissant l’exclusion, vos liens et contenus n’y apparaissent plus, et ces fonctions ne vous envoient plus aucun trafic.
Ce réglage n’est pas un signal de classement pour le reste de la recherche, et il ne touche pas à l’entraînement (Google renvoie là à Google-Extended). Comptez un à deux jours, parfois plus, pour que l’exclusion s’applique. Pour sortir complètement de Google, il faut noindex ; pour limiter ce qui s’affiche, nosnippet ou max-snippet.
Apple suit une logique voisine : Applebot-Extended "ne visite pas les pages", et nosnippet retire un contenu des réponses générées par Siri.
Comment écrire un robots.txt par rôle sur WordPress ?
Sans fichier physique à la racine, WordPress fabrique un robots.txt virtuel. Dans la version 7.1.2, il part d’un groupe User-agent: * qui interdit /wp-admin/ mais autorise admin-ajax.php, puis passe par le filtre robots_txt. Dès qu’un vrai fichier existe, le serveur le sert directement. Le reste est dans mon guide du fichier robots.txt pour WordPress.
Une règle de la norme (RFC 9309) piège beaucoup de monde : un robot suit le groupe qui porte son nom, et ne se rabat sur le groupe * que si aucun groupe ne le nomme. Vos interdictions générales ne s’appliquent donc plus à GPTBot dès que vous lui créez un groupe. D’où les lignes répétées ci-dessous.
Voici un fichier qui refuse l’entraînement mais garde la recherche IA. La norme autorise plusieurs lignes User-agent dans un même groupe :
# Refuser l'entraînement des modèles
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

# Rester visible dans les recherches IA
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: MistralAI-Index
User-agent: Amzn-SearchBot
User-agent: meta-webindexer
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Les agents (ChatGPT-User, Claude-User, Perplexity-User) relèvent ici du groupe * ; plusieurs ne liraient de toute façon pas ces lignes. Sur un site sans fichier physique, le même refus passe par le filtre robots_txt, dans une petite extension maison :
add_filter( 'robots_txt', function ( $output, $public ) {
	if ( ! $public ) {
		return $output; // Site masqué aux moteurs : rien à ajouter.
	}
	$refus = array( 'GPTBot', 'ClaudeBot', 'Google-Extended', 'Applebot-Extended', 'meta-externalagent', 'Amazonbot', 'MistralAI-Training', 'CCBot' );
	$output .= "\n";
	foreach ( $refus as $robot ) {
		$output .= "User-agent: {$robot}\n";
	}
	$output .= "Disallow: /\n";
	return $output;
}, 10, 2 );
robots.txt n’est qu’une demande : comment faire respecter vos choix ?
La norme le dit elle-même : ces règles "ne sont pas une forme d’autorisation d’accès". Un robot poli les suit, un imposteur emprunte son nom. Common Crawl prévient d’ailleurs que des robots "s’identifient faussement comme CCBot".
Les mesures vont dans ce sens. Une étude présentée à la conférence ACM IMC 2025 (Kim et al.), qui a suivi 130 robots déclarés pendant 40 jours, conclut que certaines catégories, "dont les robots de recherche IA, vérifient rarement robots.txt". L’ancienne version de cette page lui prêtait un chiffre de 13 % qui n’y figure pas.
En août 2025, Cloudflare a aussi accusé Perplexity de masquer l’identité de ses robots face à un blocage, "sur des dizaines de milliers de domaines". Une accusation, pas un jugement.
Pour vérifier qu’un robot est authentique, croisez son nom avec son adresse : la plupart des éditeurs du tableau publient leurs adresses IP, souvent en JSON, et Apple comme Google proposent le DNS inverse. Attention toutefois : Anthropic prévient qu’un blocage par adresse IP gêne la lecture de votre robots.txt et ne garantit pas durablement votre refus.
Côté serveur : Apache et Nginx
Sur Apache, quelques lignes en tête du .htaccess (voir mes règles .htaccess pour WordPress) renvoient une erreur 403. Cette version ne vise que les adresses dynamiques d’une boutique (adaptez les slugs panier, commande et compte) :
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (meta-externalagent|meta-webindexer) [NC]
RewriteCond %{QUERY_STRING} (^|&)(wc-ajax|add-to-cart)= [NC,OR]
RewriteCond %{REQUEST_URI} ^/(panier|commande|mon-compte)/ [NC]
RewriteRule .* - [F,L]
</IfModule>
Sur Nginx, une table map dans le bloc http, puis un test dans le bloc server :
map $http_user_agent $robot_refuse {
    default 0;
    ~*(meta-externalagent|meta-webindexer) 1;
}

server {
    # ... votre configuration habituelle
    if ($robot_refuse) {
        return 403;
    }
}
Attention : cette version Nginx va plus loin que la règle Apache. Elle refuse tout le site aux deux robots, y compris meta-webindexer, ce qui rend aussi vos pages publiques moins visibles dans la recherche de Meta AI. Pour les garder visibles, retirez meta-webindexer de la table ; pour ne viser que les adresses de la boutique, comme sous Apache, combinez l’agent et l’adresse dans une seconde table map dont la source réunit les deux (par exemple "$robot_refuse:$request_uri"), puis testez cette nouvelle variable à la place de $robot_refuse.
Rien d’irréversible là-dedans, contrairement à ce qu’affirmait l’ancienne version de ce guide : vous retirez les lignes, le robot revient. Mais chaque refus mobilise encore le serveur, ce qu’un pare-feu placé en amont évite.
En périphérie : le pare-feu du CDN
Sur la boutique dont je vous parle plus bas, la règle du .htaccess n’a pas suffi seule. La parade décisive s’est jouée avant le serveur, dans une règle de pare-feu Cloudflare placée en première position, avec l’action "Block" et cette expression :
(http.user_agent contains "meta-externalagent") or (http.user_agent contains "meta-webindexer")Mon robots.txt, ligne par ligne : pourquoi je ne bloque (presque) rien
Ma position, je la formule comme je la pense : "Non, je ne bloque aucun robot IA. J’ai aucun problème avec ça. De toute façon, il y a toutes sortes de robots aujourd’hui, donc un de plus, un de moins, ça ne changerait rien."
Extraits de mon fichier en ligne, relus le 29 septembre 2026 :
User-agent: *
Content-Signal: ai-train=yes, search=yes, ai-input=yes
Allow: /
Disallow: /api/
Disallow: /signer/

User-agent: GPTBot
Allow: /
Allow: /api/mcp/
Disallow: /api/
Disallow: /signer/

User-agent: Bytespider
Disallow: /
Onze robots d’IA ont leur groupe nommé, tous ouverts, de GPTBot à amazonbot en passant par Claude-SearchBot, Perplexity-User et Google-Extended. Chaque groupe répète les deux interdictions de sécurité, avec une exception : /api/mcp/, l’adresse de mon serveur MCP public, que je veux justement ouverte aux agents.
Fidèle à ma phrase ? Presque. Dans ce fichier, une seule interdiction subsiste, celle de Bytespider, le robot sans documentation. Apple, Meta, Mistral et les deux autres robots d’Amazon ne sont pas nommés : ils tombent dans le groupe général et entrent aussi.
llms.txt, Content-Signal : guider plutôt que verrouiller
La ligne Content-Signal vient d’une politique publiée par Cloudflare en septembre 2025 : des signaux (search, ai-input, ai-train), chacun à yes ou no. Une déclaration d’intention. Aucune des documentations d’OpenAI, d’Anthropic, de Google, de Perplexity, d’Apple ou de Mistral ne la mentionne.
Même silence sur llms.txt : aucune de ces pages ne dit que ses robots lisent ce fichier, alors qu’OpenAI et Perplexity en publient un pour leur propre documentation.
Je publie quand même le mien, un résumé de mon site taillé pour les IA : un guide de visite, qui n’autorise ni n’interdit rien et que chaque robot lit s’il le veut. J’en discute l’intérêt dans mon article sur le fichier llms.txt.
Pourquoi ouvrir autant, alors ? L’échange reste pourtant déséquilibré : Cloudflare a mesuré en 2025 chez Anthropic jusqu’à 500 000 pages explorées pour un seul renvoi vers un site, au plus fort de l’année. Mais je veux être cité, et la citation se travaille dans le texte. J’ai créé OGEEAT, une extension gratuite, précisément pour ce travail de citabilité.

OGEEAT - v2.7.1 - ⭐ 5/5 (7 avis) - +200 installations - par wpformation
Elle gère l’identité de l’auteur, les fichiers llms.txt, un score GEO sur 12 critères, un suivi de la visibilité IA et un pare-feu qui couvre 52 robots d’IA, pour qui veut trier. Le détail est dans ma présentation d’OGEEAT.
Un mot sur le GEO, puisque l’ancienne page citait mal l’étude fondatrice (Aggarwal et al., KDD 2024) : son gain de 41 % est celui de la meilleure méthode, sur une seule métrique. Citer ses sources a fait grimper de 115,1 % la visibilité des sites classés cinquièmes… et baisser de 30,3 % celle des premiers.
La méthode est dans mon guide GEO pour WordPress, et je vous invite à mesurer votre point de départ avec l’outil Score GEO.
Cloudflare, Vercel, Kinsta : que proposent les hébergeurs et les CDN ?
Cloudflare a changé les règles à plusieurs reprises en quinze mois. Les dates qui comptent pour un site WordPress :
- 1er juillet 2025 : Cloudflare change son réglage par défaut pour bloquer les robots d’IA, sauf s’ils rémunèrent les créateurs ;
- 24 septembre 2025 : politique Content Signals, déclarative ;
- 21 août 2026 : Bot Preference Sync, qui écrit vos choix en tête de votre robots.txt ;
- 15 septembre 2026 : nouveau réglage "Disallow AI Training", abandon annoncé de "Block AI Bots", et un "Block" qui touche désormais Googlebot, Applebot et Bingbot.
Sur toutes les offres, AI Crawl Control (ex-AI Audit) montre quels services d’IA visitent votre contenu et lesquels suivent vos directives. Le paiement à l’exploration reste en bêta privée : un robot qui ne paie pas reçoit une réponse HTTP 402.
Selon Cloudflare, moins de 1 % de ses sites bloquent les robots de recherche, mais 17 % bloquent l’entraînement. Son nouveau réglage publie donc un refus d’entraînement dans robots.txt et laisse passer pour la recherche les robots d’Apple, de Google et de Microsoft. Microsoft, lui, vise le début 2027 pour que Bing lise ce refus dans robots.txt.
Le bouton Block a changé de sens : depuis le 15 septembre 2026, choisir "Block" dans le réglage d’entraînement de Cloudflare arrête aussi Googlebot, Applebot et Bingbot, donc votre référencement. Pour refuser l’entraînement en restant dans les moteurs, choisissez "Disallow AI Training".
Chez Vercel, qui sert le front de wpformation.com au 29 septembre 2026, un jeu de règles géré "AI bots" existe sur toutes les offres, en mode journal ou refus, avec une liste tenue à jour par Vercel. Kinsta propose un contrôle "Bloquer les robots d’IA", "y compris ceux qui sont vérifiés", sans toucher à Googlebot ni à Bing.
Les robots IA font-ils vraiment tomber un WordPress ?
Rarement, mais le risque se concentre sur quelques sites. Sur plus de 5 000 sites WordPress de son infrastructure, Kinsta mesure que le site médian consacre 1,57 % de sa bande passante aux robots IA, contre 17,8 % au 90e centile et 90,3 % au 99e. Plus de 1 000 sites n’en reçoivent aucun.
Côté requêtes, la médiane tourne entre 33 et 67 par site et par jour, la moyenne entre 667 et 928 : quelques sites très sollicités tirent tout vers le haut. À l’échelle du Web, Cloudflare attribue en 2025 aux robots IA 4,2 % des requêtes HTML, et 4,5 % à Googlebot seul.
Le vrai sujet, c’est le cache. Selon Kinsta, 76,3 % des requêtes humaines sont servies depuis le cache, contre 10,4 % des requêtes de robots IA ; et 84,1 % des requêtes de ces robots portent sur du contenu dynamique, contre 18,6 % chez les humains. Un visiteur lit des articles déjà prêts. Un robot fouille la recherche, les filtres, le panier… et à chaque fois, PHP et la base travaillent.
Le cas extrême vient du rapport d’avril 2026 de Kinsta : ClaudeBot a envoyé 3,75 millions de requêtes vers des adresses d’ajout au panier en 24 heures, près de la moitié des 7,67 millions observées ce jour-là, soit "environ une requête toutes les 23 millisecondes".
Je prends ces chiffres avec des pincettes. Kinsta ne publie ni le mode de sélection des sites, ni la liste des robots comptés comme IA, ni les dates de mesure. Son parc tourne sur l’infrastructure gérée par Kinsta, loin d’un mutualisé à 35 connexions, et l’hébergeur vend un blocage sélectif. Restent solides l’écart entre médiane et moyenne, et le poids du dynamique.
Et votre site, dans quelle case tombe-t-il ? Seuls vos journaux le disent (j’y viens plus bas).
Une boutique, un robot, 27 % du trafic : le récit d’une panne
Je maintiens cette boutique WooCommerce au forfait depuis avril 2026 : une quarantaine d’extensions, un site bilingue, un hébergement mutualisé derrière l’offre gratuite de Cloudflare.
Le 27 juin, le symptôme arrive par petites touches. "Error establishing a database connection" s’affiche (l’erreur que je décortique dans mon guide sur l’erreur de connexion à la base de données), un rafraîchissement la fait disparaître, puis elle revient. Le site rame…
Les journaux racontent vite l’histoire. Le robot de Meta pèse environ 27 % de tout le trafic et frappe là où ça fait mal : 558 requêtes sur le panier, 7 362 appels POST aux fragments de panier de WooCommerce, environ 1 800 à l’API du bandeau de cookies. Chaque appel ouvre une connexion à la base de données. Le compte en autorise 35.
La parade initiale se joue sur le serveur : un bloc en tête du .htaccess renvoie une erreur 403 aux robots de Meta sur les chemins dynamiques. Sous saturation, les connexions déjà ouvertes y échappent. La règle Cloudflare montrée plus haut, posée en première position, fait la différence : à la seconde du blocage, les erreurs 500 passent d’environ 40 par minute à zéro.
Dès le lendemain, les erreurs 500 repartent à l’origine : 219 073 sur la journée du 28 juin. Cette fois, pas de robot déclaré : des centaines d’adresses IP se font passer pour des navigateurs, 14 requêtes au plus chacune, sur des pages catégorie et produit que le cache ne partage pas. Impossible de dire pour qui elles travaillent.
Un cron WordPress livré à lui-même en rajoute : 1 616 appels POST à wp-cron.php dans la journée du 29 (son fonctionnement est détaillé dans mon guide de WP-Cron).
Côté Cloudflare, un défi cible alors ces pages pour le trafic non vérifié, affiné ensuite pour ne viser que l’étranger et le trafic suspect : les clients français ne voient aucun écran. Le cron passe au système, toutes les cinq minutes par WP-CLI. La charge du serveur descend de 8,1 à 3,8.
La cause de fond se cachait dans le cache lui-même : ces pages étaient conservées visiteur par visiteur au lieu d’être partagées. Le 1er juillet au matin, les erreurs 500 à l’origine étaient tombées à 6.
Le défi a un prix, inscrit au suivi : un robot d’IA légitime venu de l’étranger, absent de la liste des robots vérifiés par Cloudflare, peut s’y heurter. Les aperçus de partage Facebook, eux, passent par facebookexternalhit, un autre robot de Meta, resté hors de la règle.
Pièges d’URL : la liste de contrôle pour WordPress et WooCommerce
Aucune des sources relues pour ce guide ne publie de mesure par type d’adresse WordPress : ce qui suit est une liste de contrôle, pas un classement. Kinsta a par exemple vu meta-externalagent parcourir en boucle des variantes de paramètres, chacune prise pour une page nouvelle. Les adresses à chercher dans vos journaux :
?s=: la recherche interne, que WordPress marque déjànoindexdepuis la version 5.7 ;?replytocom=: les liens "Répondre" des commentaires, une adresse par commentaire ;?m=et les archives par date, qu’un calendrier en barre latérale multiplie ;/page/2/et au-delà : la pagination profonde ;/feed/: un flux par catégorie, par étiquette et, pour les commentaires, par article ;/wp-json/: l’API REST, dynamique par nature ;add-to-cart=et?wc-ajax=: les actions et les fragments du panier ;orderby=,filter_,min_price=: tris et filtres du catalogue, combinables à l’infini.
WooCommerce - v11.2.2 - ⭐ 4.5/5 (4 833 avis) - +7 000 000 installations - par Automattic
Dans le code de WordPress 7.1.2 et de WooCommerce 11.1.2, relu le 29 septembre 2026, ces paramètres existent tous. Pour les adresses d’action et de tri, robots.txt reste la réponse la plus simple, à ajouter au groupe * existant :
User-agent: *
Disallow: /*add-to-cart=
Disallow: /*orderby=
Disallow: /*filter_
Un garde-fou, tout de même : ne bloquez pas une page que vous voulez voir sortir de l’index par un noindex, le robot ne pourrait plus lire la balise (mon propre robots.txt garde un commentaire sur ce piège). Et répétez ces lignes dans chaque groupe nommé, puisque GPTBot et ses cousins ignorent le groupe * dès qu’ils ont le leur.
Pourquoi les robots IA ne voient-ils pas votre JavaScript ?
Parce que la plupart ne l’exécutent pas. Vercel a analysé les robots d’IA passés sur son réseau fin 2024 : ceux d’OpenAI (OAI-SearchBot, ChatGPT-User, GPTBot), ClaudeBot, meta-externalagent, Bytespider et PerplexityBot n’exécutaient pas JavaScript. Gemini, adossé à l’infrastructure de Googlebot, et Applebot, qui passe par un navigateur, le font.
ChatGPT et Claude téléchargent pourtant des fichiers JavaScript (11,50 % et 23,84 % de leurs requêtes), sans les exécuter. Et ChatGPT passait 34,82 % de ses requêtes sur des pages 404. Ces données datent de décembre 2024 : les robots ont pu évoluer depuis.
Sur un WordPress classique, la page arrive déjà construite par PHP, texte compris. Le risque se niche dans ce qu’une extension charge après coup. Vos avis clients s’affichent-ils sans JavaScript ? Onglets remplis à la volée, filtres de produits, widgets… un contenu qui n’existe qu’une fois le script exécuté reste invisible pour ces robots.
Autre conséquence : un robot qui n’exécute pas JavaScript ne déclenche pas non plus le marqueur de Google Analytics. Vous ne le verrez que dans les journaux du serveur.
WordPress découplé : ce que les robots frappent vraiment chez moi
Au 29 septembre 2026, le site que vous lisez n’est plus servi par WordPress. Un front en Next.js, hébergé chez Vercel, affiche les pages ; WordPress tourne sur un autre serveur et fournit le contenu à ce front par son API, selon le principe du WordPress headless. J’en ai tiré un bilan chiffré après sept mois en production.
Les pages HTML de WordPress redirigent vers le front et portent un noindex. Le robots.txt que vous venez de lire répond d’ailleurs avec l’en-tête Server: Vercel.
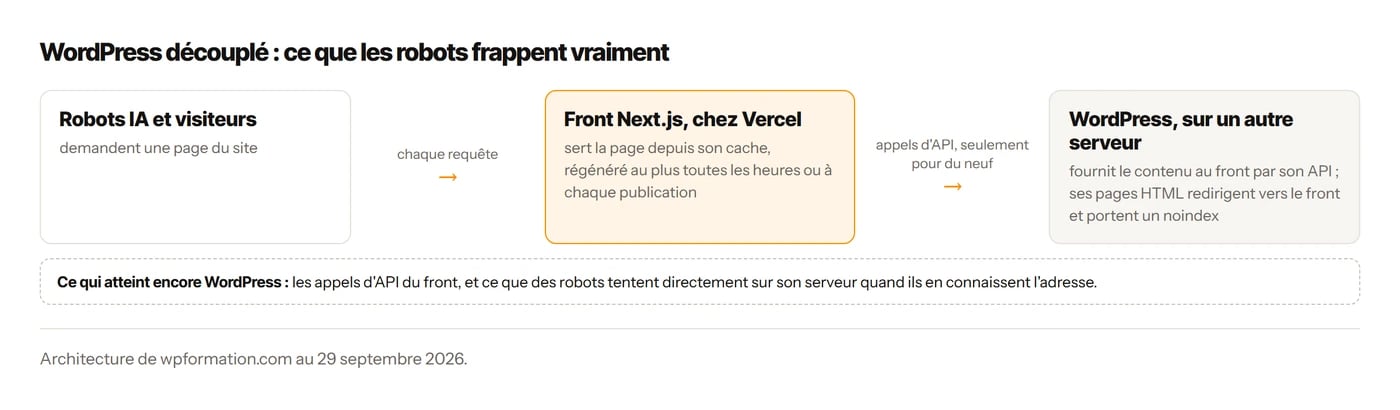
Un robot demande une page, le front la lui sert depuis son cache, régénéré au plus toutes les heures ou à chaque publication. WordPress ne travaille que lorsque le front vient chercher du neuf. La recherche, par exemple, est une page du front, marquée noindex.
Ce qui atteint encore WordPress : les appels d’API du front, et ce que des robots tentent directement sur son serveur quand ils en connaissent l’adresse.
Comment désactiver l’IA dans WordPress 7 ?
Changement de sujet complet : votre site appelle lui-même une IA. WordPress 7.0, sorti le 20 mai 2026, embarque un client IA commun aux extensions et un écran Réglages > Connecteurs, avec trois fournisseurs par défaut (Anthropic, Google, OpenAI). Le cœur n’embarque aucun fournisseur : sans extension de fournisseur ni clé d’API, son client IA n’a personne à qui parler.
Pour tout couper, une ligne dans wp-config.php, au-dessus de la ligne qui vous demande d’arrêter les modifications :
define( 'WP_AI_SUPPORT', false );Dans le paquet de WordPress 7.1.2, relu le 29 septembre 2026, la fonction wp_supports_ai() teste la constante avant tout filtre et renvoie alors false. Trois endroits du cœur la consultent : l’enregistrement des fournisseurs par défaut (sautés), le registre des connecteurs (tout fournisseur d’IA refusé) et le constructeur de requêtes du client IA.
Côté extensions, les méthodes is_supported_*() répondent alors false, et les méthodes generate_*() renvoient une erreur prompt_prevented (statut 503) sans qu’aucun appel ne parte. À noter : le connecteur d’Akismet, qui n’est pas un fournisseur d’IA, reste enregistré.
Couper au cas par cas avec les filtres
Le filtre wp_supports_ai, présent depuis WordPress 7.0, fait la même chose requête par requête. Son commentaire dans le code l’autorise même à "passer outre les préférences explicites définies par le propriétaire du site". La constante à false, elle, l’emporte toujours.
add_filter( 'wp_supports_ai', '__return_false' );Placez-le dans un mu-plugin : le registre des connecteurs se construit sur le crochet init, en priorité 15, et votre filtre doit exister avant. Pour garder l’IA mais la réserver, le filtre wp_ai_client_prevent_prompt bloque des requêtes précises. Exemple, l’IA réservée aux administrateurs :
add_filter( 'wp_ai_client_prevent_prompt', function ( $prevent, $builder ) {
	if ( ! current_user_can( 'manage_options' ) ) {
		return true;
	}
	return $prevent;
}, 10, 2 );
WP_SUPPORTS_AI n’existe pas : la constante s’écrit WP_AI_SUPPORT. Sur le forum wordpress.org, un utilisateur n’arrivait pas à vérifier que sa ligne define( 'WP_SUPPORTS_AI', false ); fonctionnait… Un modérateur lui a répondu : une coquille. Et la constante n’est documentée sur developer.wordpress.org que dans une note de contributeur, sous la page du filtre.
Sans toucher au code : Turn Off AI Features
Pour une simple case à cocher, une petite extension gratuite fait le travail (code de la version 1.0.0 relu le 29 septembre 2026).
Turn Off AI Features - v1.0.0 - ⭐ 5/5 (6 avis) - +400 installations - par AcrossAI
Elle ajoute une option dans Réglages > Général. Cochée, elle définit elle-même WP_AI_SUPPORT à false, ajoute le filtre en priorité 1000 et coupe l’IA de deux extensions tierces par leurs propres filtres, dont Jetpack. Elle n’est testée que jusqu’à WordPress 7.0.6.
Petite surprise : la description de sa fiche annonce wp ai disable, alors que sa FAQ et son code enregistrent wp toaif disable, la seule commande qui existe.
Pourquoi viser Jetpack à part ? Parce que la constante ne coupe que ce qui passe par le client IA du cœur, ou ce qui consulte wp_supports_ai(). En juin 2026, l’équipe de Jetpack confirmait sur le forum officiel que l’extension "ne lit ni la constante WP_AI_SUPPORT ni le filtre wp_supports_ai" pour charger ses fonctions IA.
Ce n’est plus vrai depuis la version 16.2 du 10 septembre 2026 : son code fait de wp_supports_ai() le premier verrou de ses fonctions IA, et la constante les coupe donc aussi.
Jetpack - v16.4 - ⭐ 3.7/5 (2 410 avis) - +3 000 000 installations - par Automattic
Sur une version plus ancienne de Jetpack, la parade reste son propre filtre, jetpack_ai_enabled. Pour les clés d’API, lisez mon guide pour sécuriser l’IA de WordPress 7 ; pour la facture, le coût réel de l’IA sur WordPress ; pour le reste, ma présentation de WordPress 7.
Comment savoir qui crawle votre site WordPress ?
Par les journaux d’accès du serveur, pas par Google Analytics. Chaque ligne porte l’adresse IP, l’adresse demandée et l’agent du visiteur.
Compter les robots dans vos journaux
Sur un journal au format "combined" d’Apache ou de Nginx, cette commande compte les requêtes par agent déclaré :
grep -Ei "gptbot|oai-searchbot|chatgpt-user|claudebot|claude-searchbot|claude-user|perplexity|meta-external|meta-webindexer|amazonbot|amzn-|mistralai|ccbot|bytespider|applebot" access.log | awk -F'"' '{print $6}' | sort | uniq -c | sort -rnEt celle-ci liste les adresses les plus demandées par un robot donné, le meilleur moyen de repérer un piège d’URL :
grep -i "meta-externalagent" access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20Vérifiez ensuite que le robot est bien celui qu’il prétend être. Apple montre l’exemple avec la commande host : l’adresse doit renvoyer un nom en applebot.apple.com. Pour les autres, comparez l’adresse aux listes JSON publiées. Si votre site passe par Cloudflare, AI Crawl Control fait une partie de ce travail pour vous.
Filtrez le bruit avant de conclure : vos propres visites de contrôle, la surveillance de disponibilité, les robots SEO et les annuaires qui recensent les fichiers llms.txt gonflent vite les compteurs.
Refaites ce comptage tous les trimestres : de nouveaux robots apparaissent, et les agents gagnent du terrain.
Qui crawle wpformation.com, en proportions
Chez moi, la mesure passe par les fichiers llms.txt, servis par le front : chaque accès y est noté avec l’agent du robot. La méthode complète est dans mes chiffres de trafic IA réel.
Une fois retirés mes propres contrôles, la surveillance, les robots SEO et les annuaires, il reste environ un accès brut sur sept venu d’un vrai assistant. Parmi ces vrais passages, le robot de ChatGPT pèse près de quatre sur dix, celui de Perplexity plus d’un tiers, celui d’Anthropic environ un sur sept.
Bloquer ou guider : ma grille, site par site
Voici comment je tranche :
| Votre site | Ce que je fais | Pourquoi |
|---|---|---|
| Blog, site vitrine, tutoriels | Rien à bloquer, un cache activé | Médiane Kinsta à 1,57 % de bande passante |
| Boutique WooCommerce en mutualisé | Journaux surveillés, blocage en périphérie des robots qui martèlent le dynamique | Un seul robot a saturé 35 connexions |
| Contenu payant, exclusif ou réservé aux membres | Refus d’entraînement, recherche ouverte | Réglages séparés chez OpenAI, Anthropic, Mistral, Amazon |
| Site derrière Cloudflare | "Disallow AI Training" plutôt que "Block" | Depuis le 15 septembre 2026, "Block" arrête aussi Googlebot |
| Site qui refuse les aperçus IA de Google | Réglage "Search generative AI" de la Search Console | Google-Extended n’y change rien |
| Site découplé | Surveiller ce qui atteint encore WordPress | Le front en cache absorbe les robots |
Mon choix ne bouge pas : sur wpformation.com, je laisse entrer et je mesure. Sur une boutique en mutualisé, je regarde les journaux et le cache avant le moindre blocage. Et dans mon robots.txt, une ligne attend toujours son lecteur : User-agent: Bytespider, puis Disallow: /.
Questions fréquentes
Les bots IA respectent-ils vraiment le robots.txt ?
La plupart des robots d’entraînement et de recherche s’y conforment, selon leurs éditeurs. Les agents déclenchés par un utilisateur peuvent l’ignorer, de l’aveu d’OpenAI, de Perplexity, de Google, de Meta et d’Amazon. Pour imposer un refus, il faut une règle serveur ou un pare-feu.
Bloquer GPTBot me retire-t-il de ChatGPT ?
Non. GPTBot ne sert qu’à l’entraînement ; la recherche de ChatGPT dépend d’OAI-SearchBot, un réglage indépendant. OpenAI indique qu’il faut environ 24 heures pour que sa recherche tienne compte d’une modification de robots.txt.
Bloquer les robots IA accélère-t-il mon site WordPress ?
Sur la plupart des sites, l’effet est faible : chez Kinsta, le site médian consacre 1,57 % de sa bande passante aux robots IA. Mais 84,1 % de leurs requêtes visent du contenu dynamique. Sur une boutique en mutualisé, un seul robot a saturé la base, et c’est le blocage en périphérie qui a fait tomber ses erreurs à zéro.
Faut-il bloquer les robots IA si je vends des formations en ligne ?
Pas pour vos pages publiques (articles, pages de vente) : elles ont intérêt à rester visibles dans les recherches IA. Pour que vos contenus n’entraînent pas de modèles, refusez les robots d’entraînement et laissez passer ceux de recherche.
WP_AI_SUPPORT bloque-t-il aussi les robots IA ?
Non. La constante coupe les appels que votre site envoie à une IA (client IA et connecteurs de WordPress 7). Les robots qui visitent vos pages relèvent de robots.txt, du serveur ou du pare-feu.
Sources
Sources primaires, toutes lues le 29 septembre 2026 :
- Robots : OpenAI, Anthropic, Google (robots communs), Google (agents), Perplexity, Apple, Meta, Amazon, Mistral, Common Crawl ;
- Google : réglage Search generative AI, fonctionnalités d’IA de la recherche, lancement en France ;
- IETF : RFC 9309, Robots Exclusion Protocol ;
- Cloudflare : 1er juillet 2025, robots en 2025, Perplexity (août 2025), Content Signals, bilan Radar 2025, Bot Preference Sync, 15 septembre 2026, AI Crawl Control ;
- Vercel : gestion des robots, étude de décembre 2024 ; Kinsta : rapport de septembre 2026, rapport d’avril 2026, article de septembre 2026 ;
- WordPress : code de la version 7.1.2, note sur le client IA, guide de la version 7.0, filtre wp_supports_ai, sujet WP_SUPPORTS_AI, sujet Jetpack, code de Jetpack 16.2 ;
- Études : Kim et al., ACM IMC 2025, Aggarwal et al., KDD 2024.
Chaque mois, je passe 15 heures en veille WordPress. Vous, vous recevez un email de 3 minutes.
Sécurité, performance, SEO, nouveautés, IA : l'essentiel trié, vérifié et expliqué par un formateur WordPress depuis 2012 et fondateur de WPServeur.
Double opt-in : un email de confirmation à valider. Max 2 emails/mois. WPFormation utilise les données saisies, via Brevo, pour votre inscription et les emails annoncés, avec votre consentement. Données jamais revendues. Désabonnement en 1 clic. Vos droits et la conservation de vos données